实测Qwen3.8-Flash:性能比肩Opus 4.6,价格仅为1/40
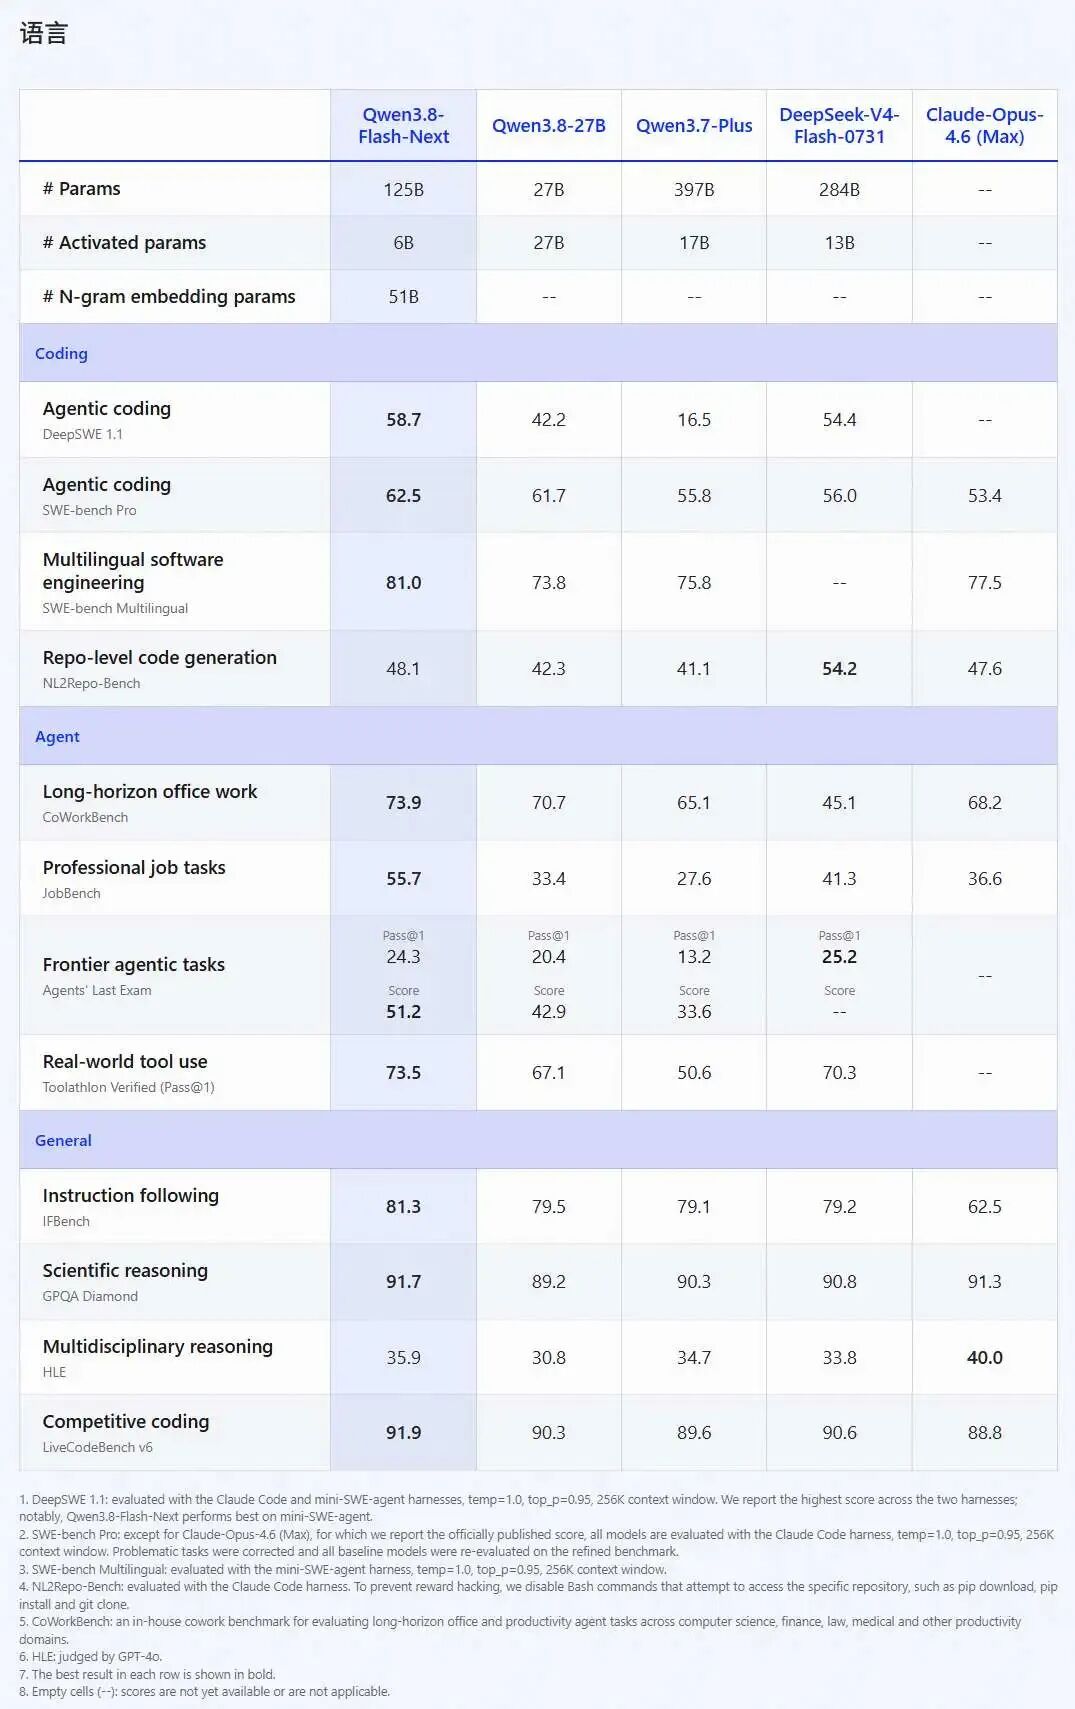
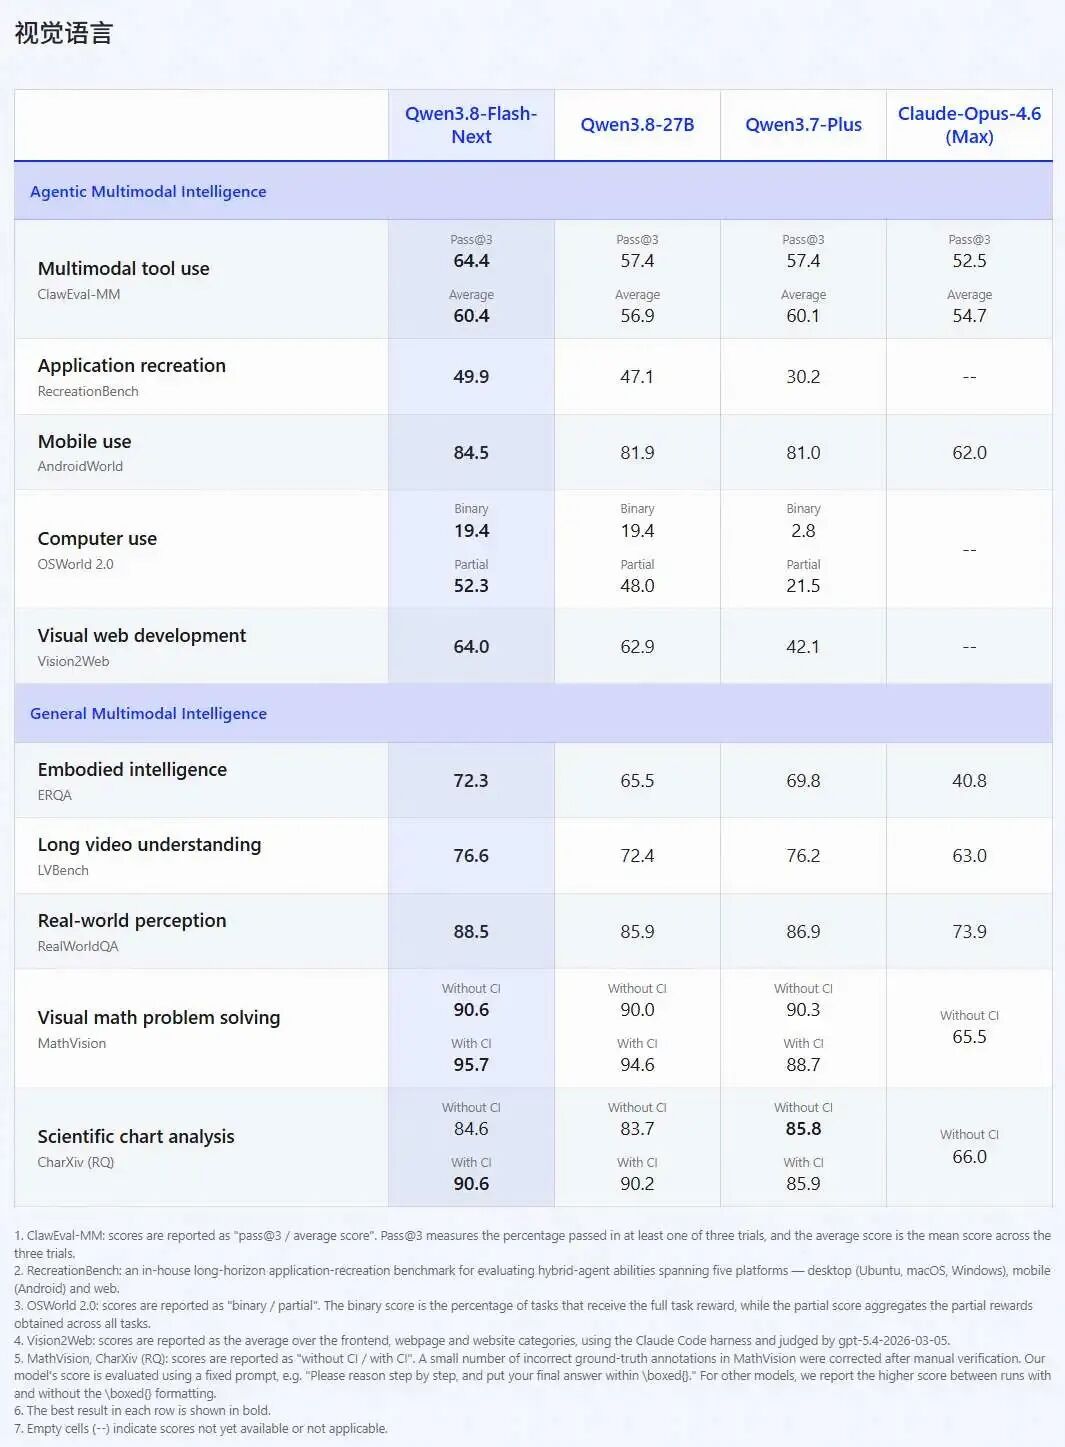
实测 Qwen3.8-Flash:125B MoE 模型,每个 Token 仅激活 6B,支持 1M 上下文。实测能生成可玩 3D 游戏、完整 3D 场景和科技产品官网,输入每百万 Token 仅 0.8 元,输出 2.7 元,缓存命中 0.1 元,比 DeepSeek-V4-Flash 便宜,不到 Opus 4.6 的 1/40。
Qwen3.8-Flash 是阿里千问最新开源的 MoE 大模型,主模型 125B 参数,每个 Token 仅激活 6B,支持 1M 上下文。实测中,它不仅能生成可玩的 3D 游戏和完整的 3D 场景,还能产出高完成度的产品官网页面。价格上,每百万 Token 输入仅 0.8 元、输出 2.7 元,缓存命中输入低至 0.1 元,比 DeepSeek-V4-Flash 忙时价格低约三分之一,不到 Opus 4.6 的四十分之一。
此前 Qwen3.8-27B 发布时,作者已经用电商网站、太空射击游戏和 3D 街区等案例验证过小模型的能力。这次 Qwen3.8-Flash 发布,相当于提前放出了 Qwen4 的架构预览,包含两个版本:Qwen3.8-Flash-Next(实验性预览,权重已开源)和 Qwen3.8-Flash(生产版)。本文所有实测均基于生产版。
核心参数与价格
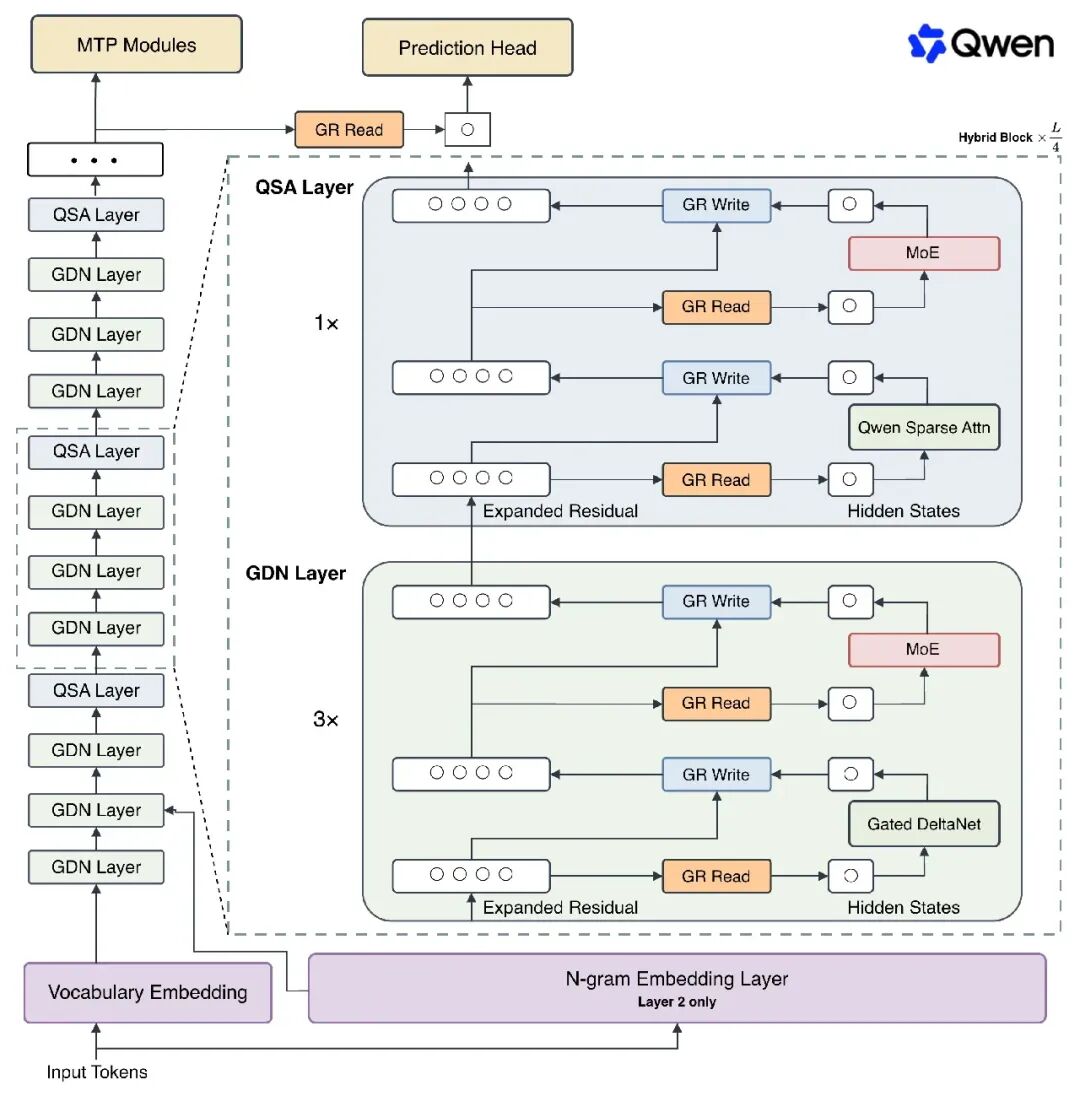
根据官方公布的信息,Qwen3.8-Flash 主要参数如下:
- 主模型 125B 参数,额外加入 51B N-gram Embedding
- 每个 Token 实际只激活 6B 参数
- 上下文长度 1M(普通模式最大输入 991K,最大输出 131K,思考模式最大思维链 262K)
价格方面,每百万 Token 输入 0.8 元,输出 2.7 元,缓存命中输入仅 0.1 元。这个价格比 DeepSeek-V4-Flash 忙时价格的三分之一还低,性价比非常突出。
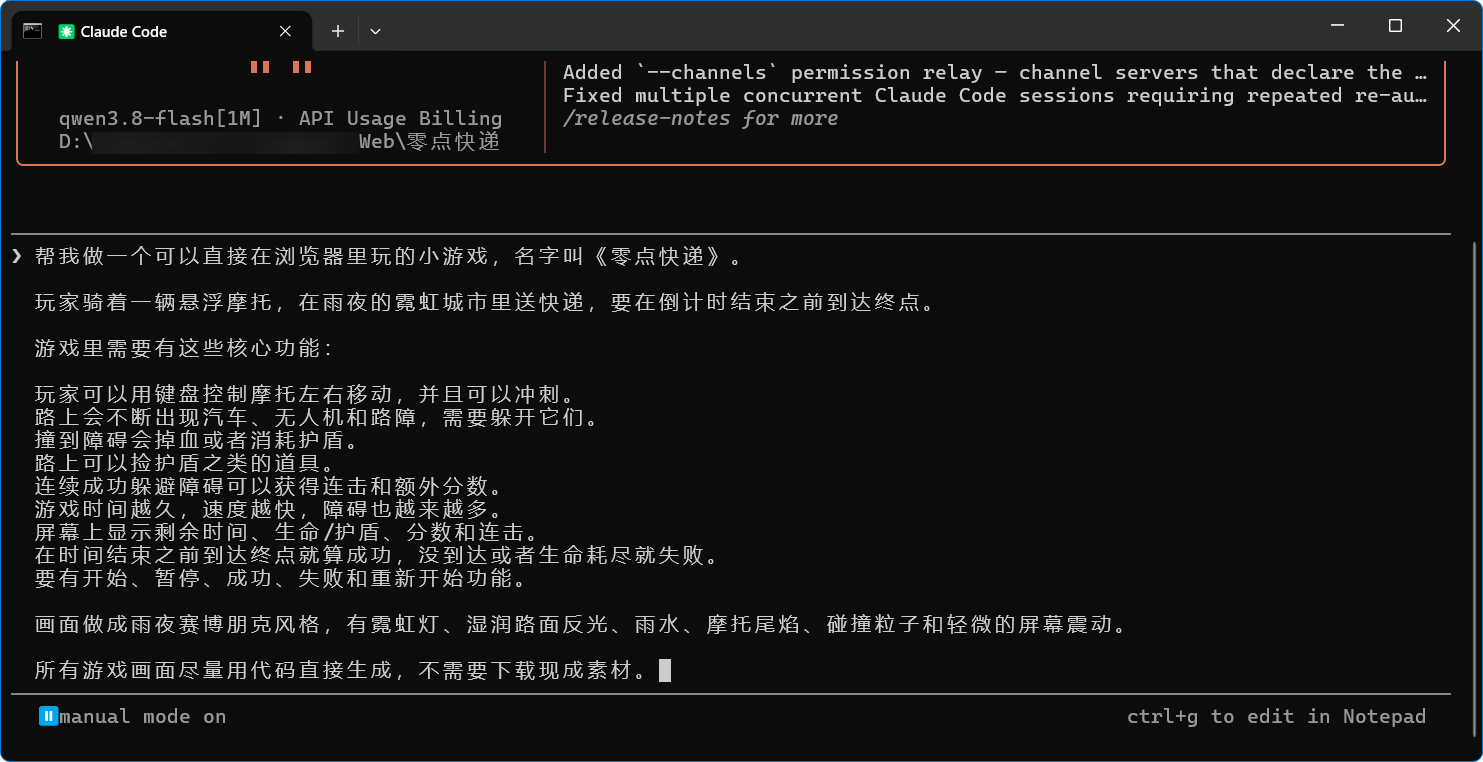
实测一:生成可玩的网页游戏《零点快递》
第一个测试项目是《零点快递》,玩家驾驶悬浮摩托在雨夜霓虹城市中送快递,需要躲避汽车、无人机和路障,在倒计时结束前到达终点。要求所有画面用代码直接生成,不下载现成素材。
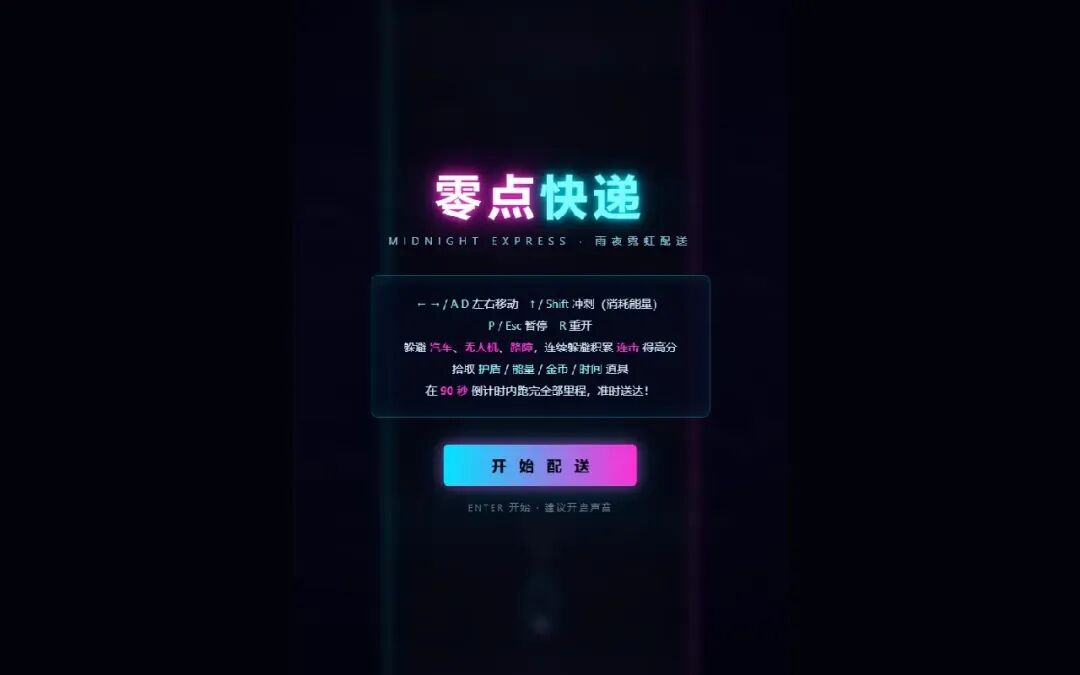
打开游戏后,雨夜、霓虹、高楼、光带全部呈现,开始页清晰标注了移动、冲刺、暂停和 90 秒倒计时。实际游玩中:
- 按住左键,摩托会向左移动,到路边不会穿模
- 按 Shift 冲刺,速度提升,能量条快速消耗
- 车辆从上方冲来,雨线持续运动,两边高楼不断后退
- 顶部有倒计时、得分和里程,底部有生命、护盾和冲刺能量
游戏逻辑完整,可以正常游玩。
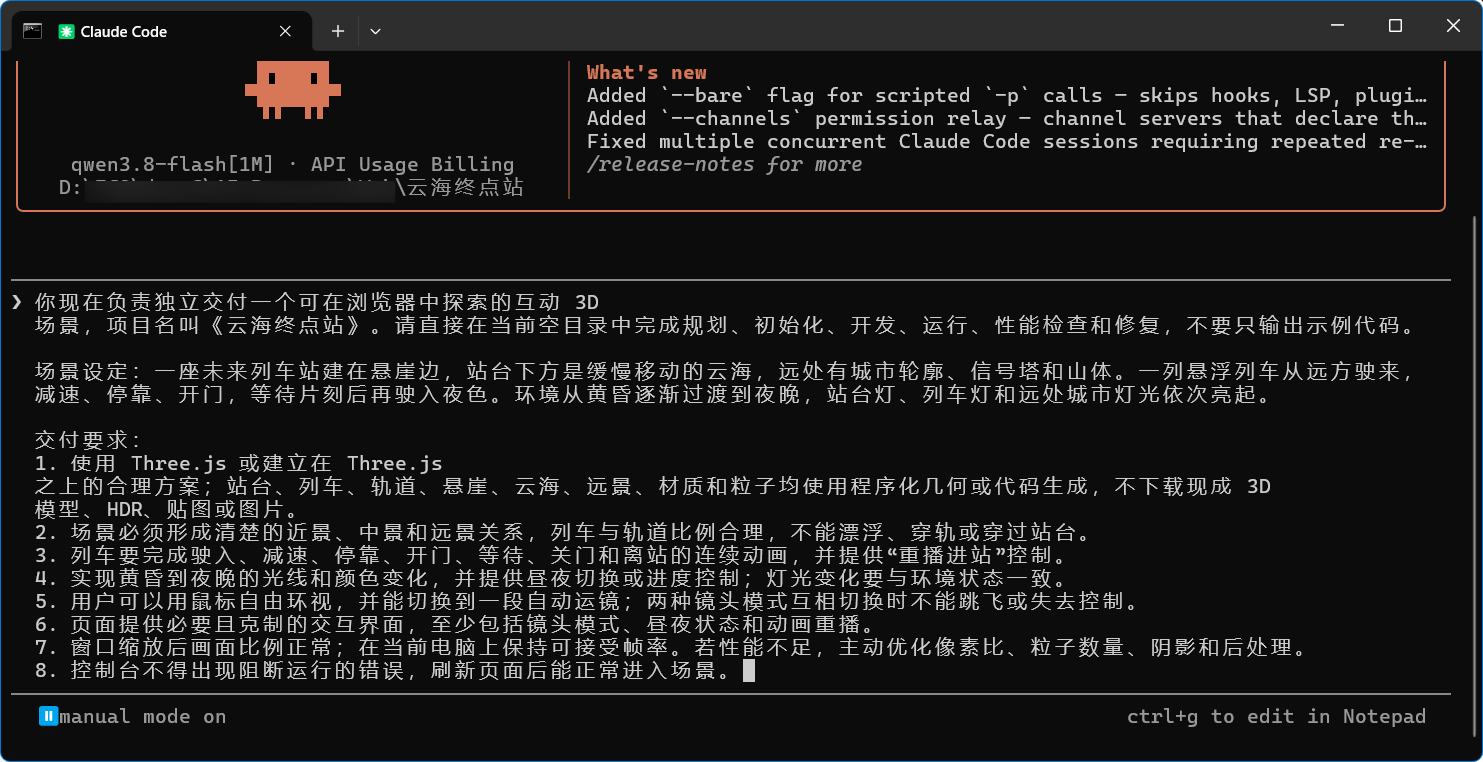
实测二:生成悬崖边的 3D 列车站《云海终点站》
第二个项目要求构建一个可直接在浏览器中探索的 3D 场景:悬崖边的未来列车站,下面是云海,远处有城市、信号塔和山体。一列悬浮列车从隧道驶来,完成减速、停靠、开门、等待、关门后驶离,环境从黄昏缓缓变为深夜。
难点在于所有元素必须同步:列车不能穿轨,车门不能乱飞,灯光要随天色变化,自由镜头和自动运镜要能切换。
场景打开后,夕阳压在海面附近,悬崖、站台、轨道、列车和远处山体形成了完整层次。左上角有控制按钮,没有满屏调试参数。实测中:
- 自动运镜会沿站台移动,视线跟随列车
- 自由环视模式支持鼠标拖拽旋转视角
- 点击重播进站,列车动画完整重放
- 昼夜切换时,灯光系统跟随变化
深夜阶段画面偏黑,主体可读性还有优化空间,但整体流程已经跑通。
实测三:打造产品官网《AETHER ONE》
第三个项目要求做一个科技产品发布页,产品名为 AETHER ONE——一块悬浮的半透明 AI 随身终端。要求首屏突出产品主体,滚动后依次介绍外观、交互、核心能力和预约,三种配色、按钮、弹窗和手机端都要真实可用。
首屏中央是一块由 Canvas 画出的半透明设备,带青蓝色边缘光、能量环和粒子效果,标题、说明和按钮围绕产品主体排布。向下滚动会依次进入外观、交互和能力章节,每段都有对应的动画。
实际交互测试:
- 极光、琥珀、星云三种配色可随时切换
- 切换后设备光效、按钮颜色、选中状态和弹窗默认模式同步变化
- 滚动位置不会因切换而丢失
- 预约弹窗支持表单校验、提交和 Escape 关闭
整体视觉接近真实的科技新品发布会页面,不是简单的 SaaS 模板。
总结:速度、能力与成本的均衡
Qwen3.8-Flash 给作者的第一感觉是快,但更令人印象深刻的是极致的性价比。除了输出价格低,它还有更关键的一点:0.1 元的缓存命中输入价格。对于真实 Agent 任务而言,工具调用、历史消息、文档资料会不断拉长输入长度,缓存命中价格的重要性会被进一步放大。
因此,Qwen3.8-Flash 真正有吸引力的地方,是把速度、能力和成本放到了相当均衡的位置。对于客服 Agent、信息检索这类高频任务,这种模型反而更容易跑进生产环境。
Agent 时代真正需要的,不只是更聪明的模型,更是能不能以足够低的成本,每天替你执行一万次。这或许才是 Flash 模型真正的价值。
目前 Qwen3.8-Flash 已上线千问 AI 平台并对外提供 API 服务。期待后续更强的模型发布。

暂无评论,期待您的发言...