GPT-6 Astra演示:从3D应用到专业工作流
据公开演示,GPT-6 Astra已能生成可运行的Mac应用和游戏,并处理3D重建、数学证明、医学科普、电路设计与数据分析。不过相关案例缺少统一测试条件,是否达到AGI仍需在正式开放后通过长任务实测验证。
现阶段更稳妥的结论不是“AGI 已经到来”,而是 GPT-6 Astra 的公开演示显示,AI 编程正在从生成代码、网页等单点任务,转向交付可运行应用、可玩游戏、三维场景及专业工作成果。由于该模型目前仅面向少数组织开放,且案例缺少统一测试条件,其真实能力仍有待正式开放后的独立实测验证。
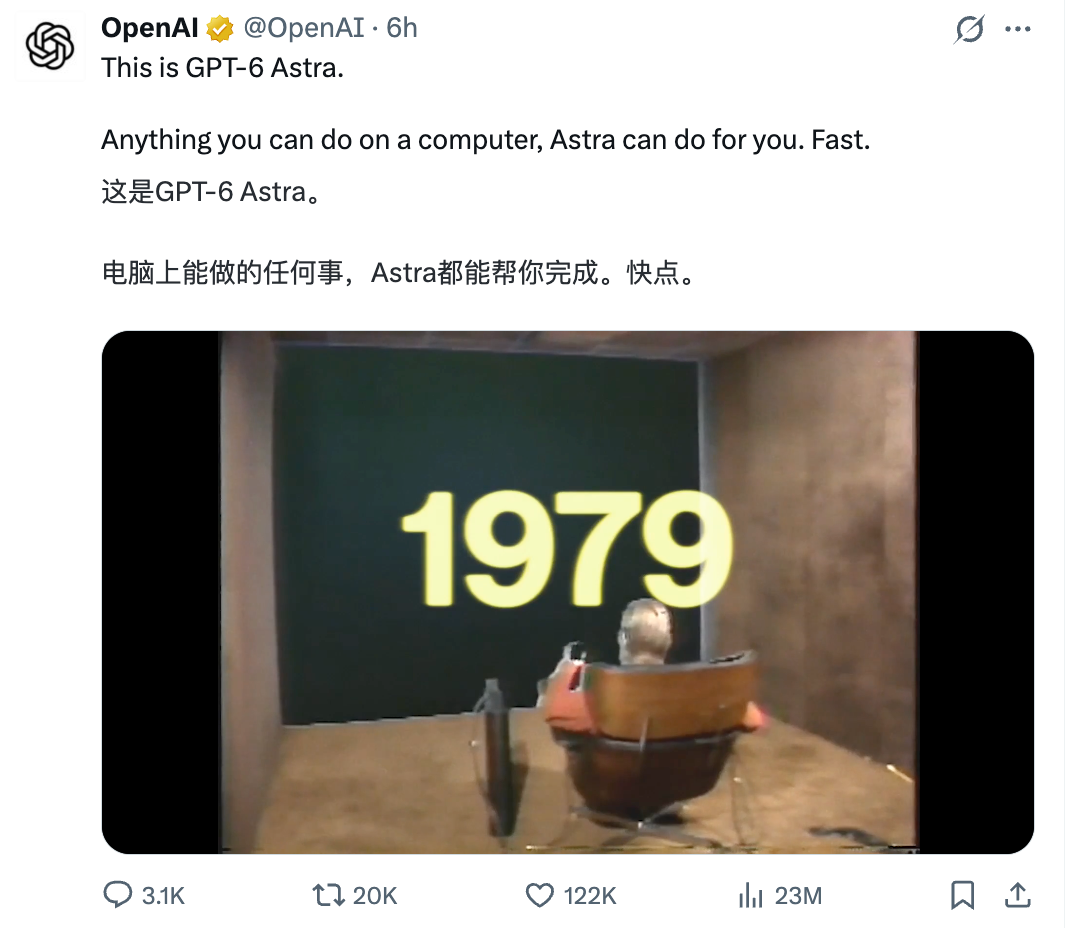
目前流出的信息主要来自早期测试者和合作机构,普通用户暂时无法完整体验。公开案例集中体现了几个方向:完整产品交付、三维空间理解,以及数学、医学和工程等专业工作流。
已能交付完整、可玩的产品
开发者 Pietro Schirano 提出的任务,是制作一款可在 Mac 上运行的应用:其中包含在 Blender 中构建的 3D iPod,保留经典 iPod 的界面与操作方式,同时支持查看 Codex 帖子。据其展示,Astra 大约用十五分钟完成了初版。
值得关注的不只是生成速度。最终结果并非静态概念图,而是具备滚轮操作、界面交互和本地运行能力的应用。这说明模型开始尝试同时处理三维资产、交互逻辑、界面设计和工程实现。
JetBrains 展示的案例则是一款交互式管弦乐应用。按照演示信息,Astra 在不到一小时内完成了视觉界面、手势识别以及与虚拟乐团互动等功能。
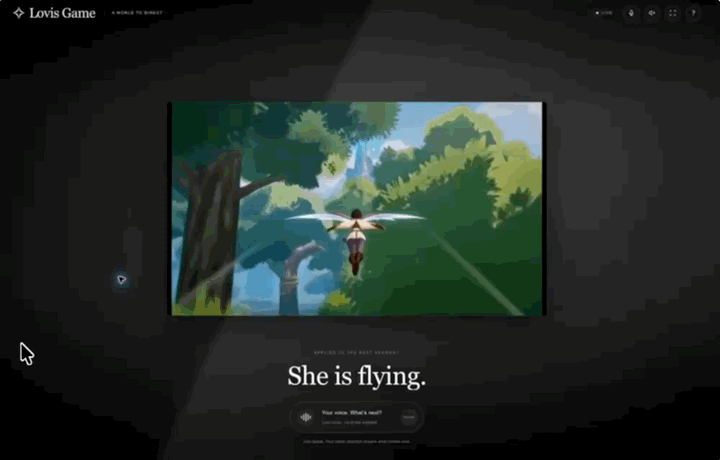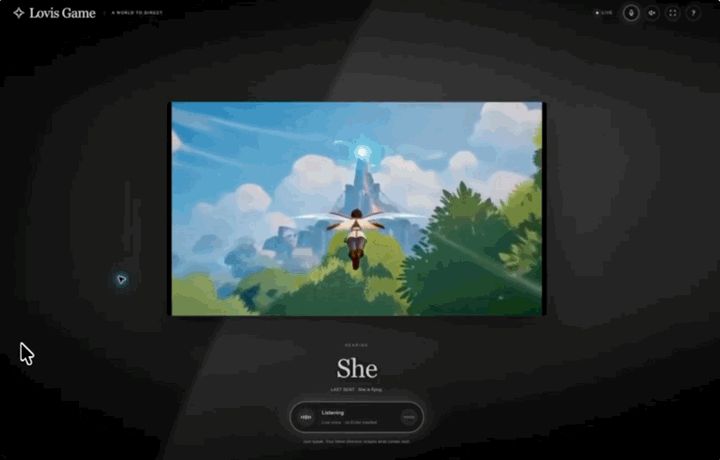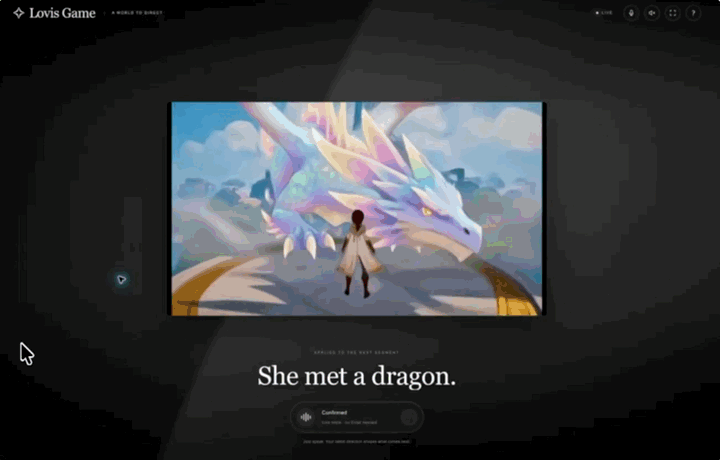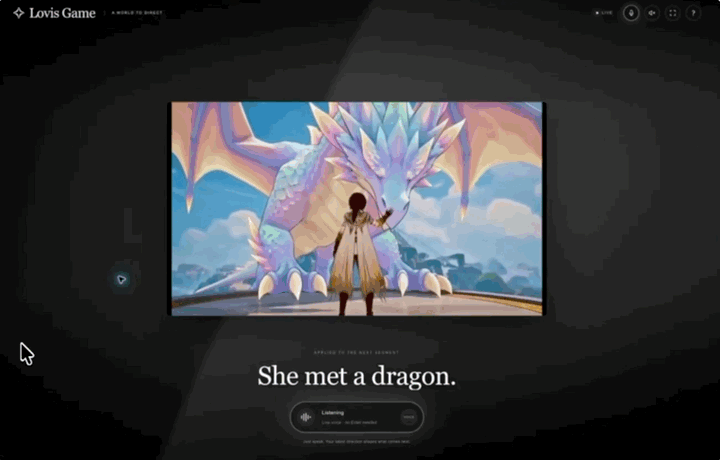
游戏开发中的表现更加直观。有测试者让 Astra 制作了一款具有《使命召唤》风格的射击游戏,并在试玩过程中继续要求模型调整玩法。公开案例显示,模型已经能够围绕一个目标持续迭代,而不是只生成一次性代码片段。
其他游戏演示也覆盖了不同画面和玩法类型。这类能力如果进一步成熟,游戏可能从固定发行的标准化产品,延伸为按照个人偏好即时生成和持续修改的内容。
空间理解和视觉判断明显提升
多项演示都指向同一个变化:Astra 对三维素材、空间关系和镜头运动的处理能力有所增强。
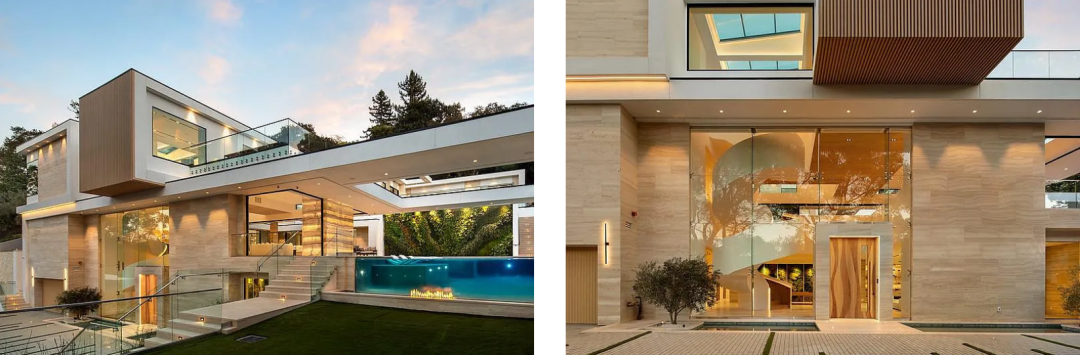
在一项房产案例中,测试者只提供了一套房源链接,页面中的照片清晰度和拍摄角度都较为有限。模型需要从这些二维图片中推断房间布局、连接关系与建筑结构。
随后,Astra 根据照片重建了整栋住宅的三维模型,并制作出包含空间漫游镜头的房产展示视频。成品仍存在细节错误,但已经串联起照片理解、空间推断、三维建模和视频制作等环节。
另一个案例仅使用参考图,就在 Blender 中重建了 Apple Park,包括环形主楼、内部绿地和周边建筑。还有测试者要求模型复刻成熟的 3D 建模工具,使其支持旋转、缩放、景深和镜头调整等功能。
对于游戏、建筑和产品设计而言,这种空间理解能力可能比单纯提升画面精细度更重要。模型不仅要“画出”物体,还要理解物体在三维空间中的位置、结构和交互方式。
开始进入专家工作台
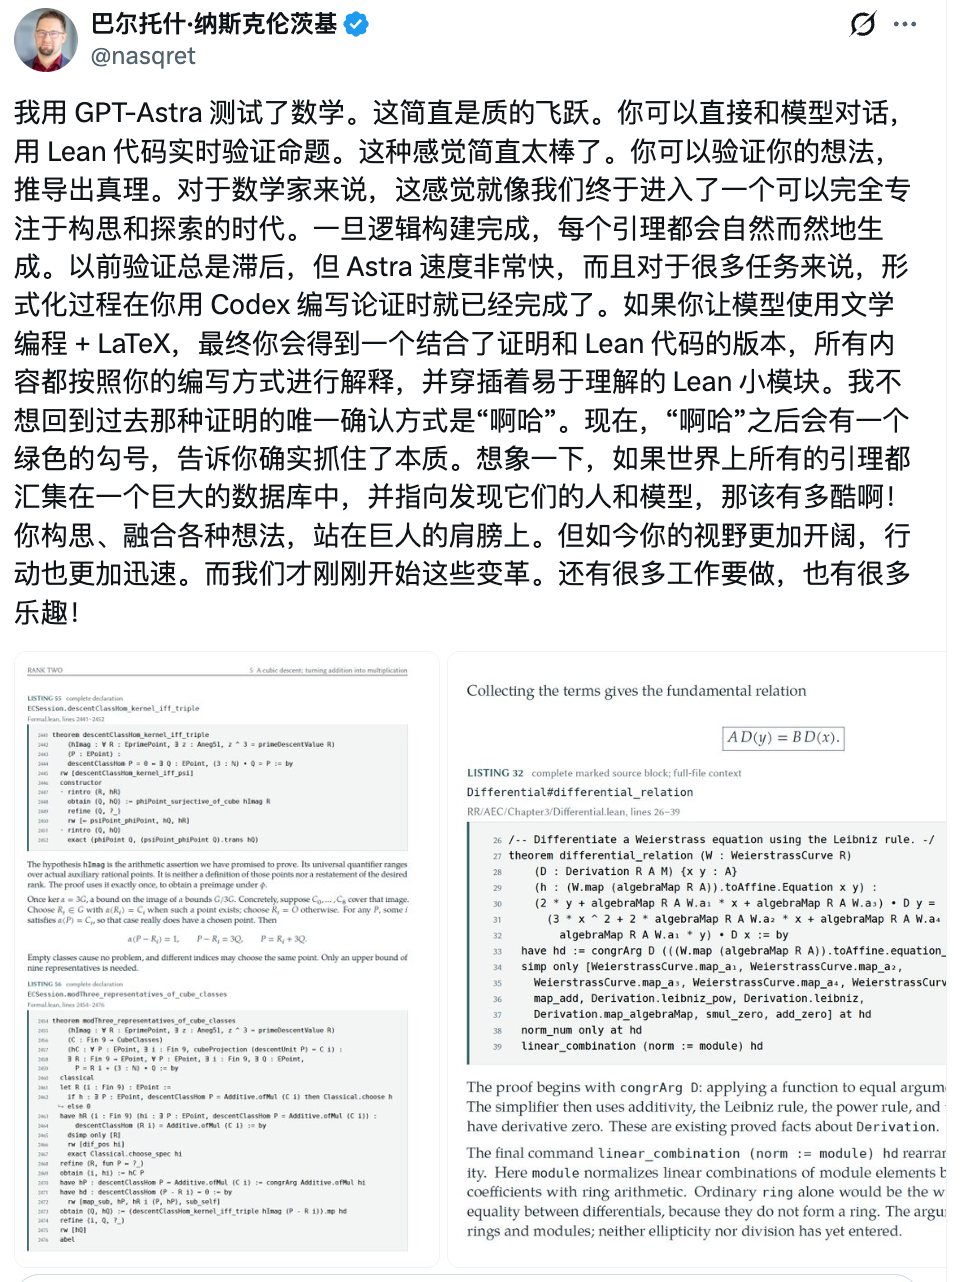
公开信息称,Astra 的内部版本曾解决或推进多个长期存在的数学问题。正式版的相关演示进一步展示了它在专业任务中的应用潜力。
过去验证复杂数学证明时,研究者通常需要将证明转写为 Lean 等形式化语言,再交由计算机逐步检查。早期使用案例显示,数学研究者可以直接与 Astra 讨论证明思路,并让模型辅助完成形式化验证过程。
数学之外,相关案例还覆盖多个专业领域:
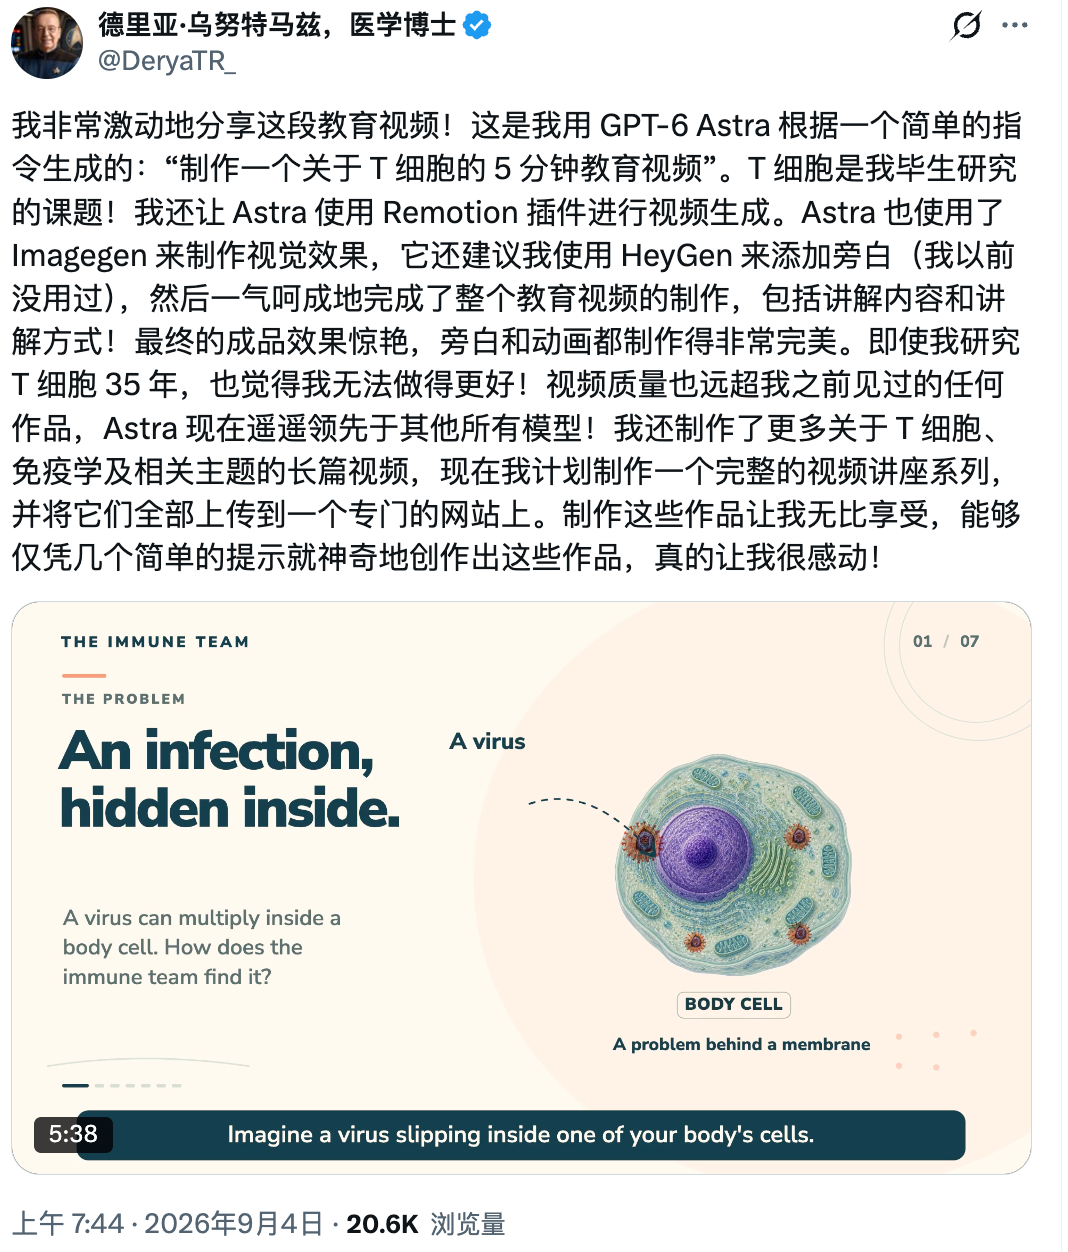
- 医学教育:根据简短要求制作一段约五分钟的 T 细胞科普视频。
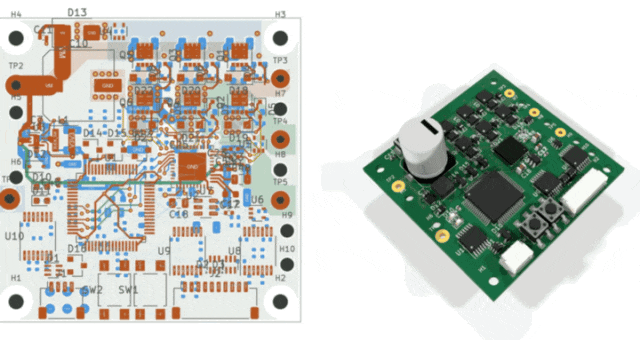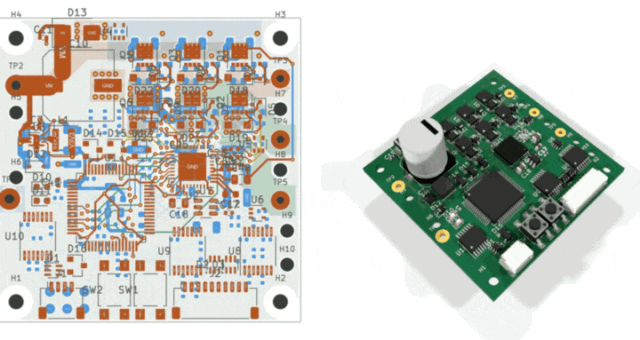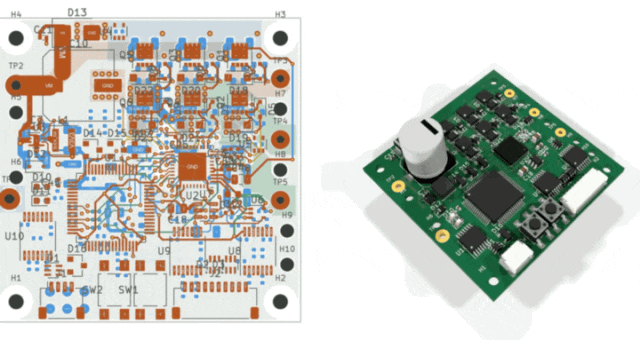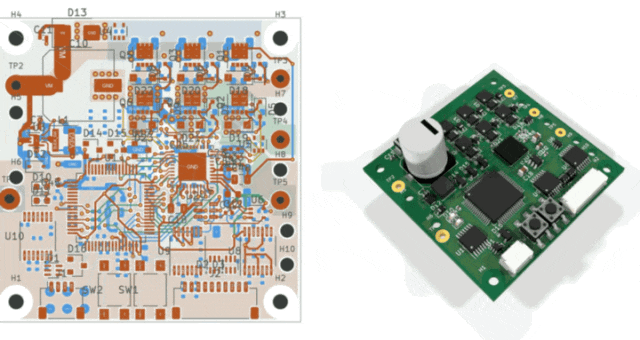
- 电子工程:进入电路设计软件,根据原理图安排元件和线路,完成电路板设计。
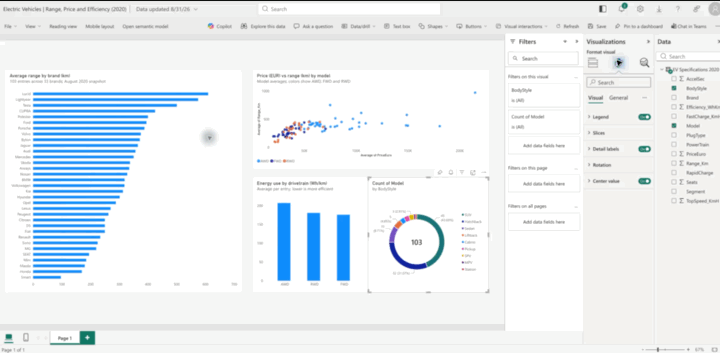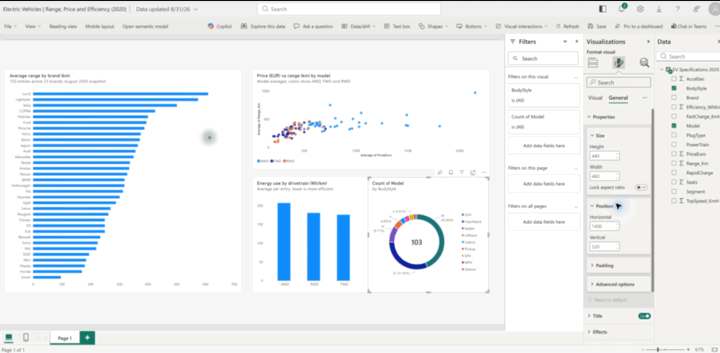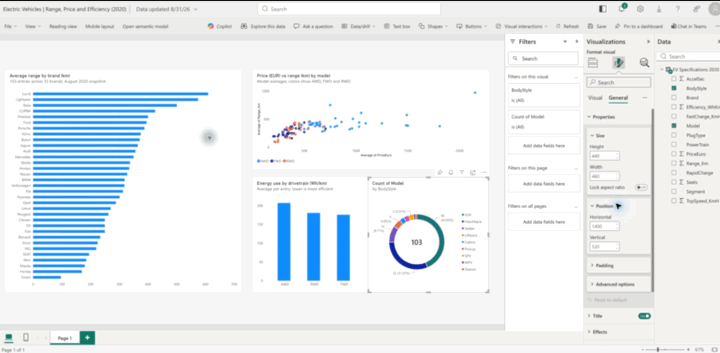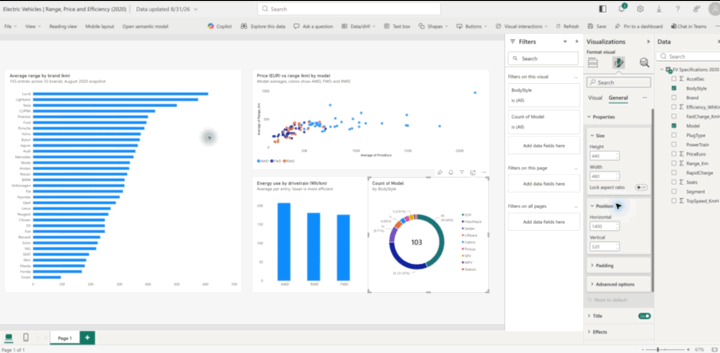
- 数据分析:操作 Power BI,将原始数据整理为图表和可交互分析页面。
- 三维设计:在 Blender 等工具中创建、修改并组织复杂场景。
这些任务的共同点是,模型不再只回答专业问题,而是进入实际软件环境,调用工具并输出可以继续修改或交付的成果。不过,演示效果并不等同于稳定的生产能力,准确性、可重复性和专业责任仍需要进一步评估。
与 Fable 5.1 的比较仍缺乏依据
目前已经出现使用相同提示词比较 GPT-6 Astra 与 Fable 5.1 的案例,任务涉及游戏开发、网站生成和三维场景制作。但不同对比得出的结论并不一致:有些展示中 Astra 优势明显,另一些案例则由 Fable 5.1 表现更好。
造成差异的因素包括:
- 提示词是否完全一致;
- 可调用工具和运行环境是否相同;
- 是否包含人工修改与多轮重试;
- 展示结果是否经过筛选;
- 完成时间、成本和失败次数是否公开。
在这些条件没有统一之前,依靠少量视频很难判断哪款模型整体更强。更有参考价值的测试,应当同时公开任务要求、操作过程、失败记录、资源消耗和最终可运行成果。
写在最后
这一批演示真正值得关注的,是测试任务本身发生了变化。过去评估新模型,常见方法是让它写文章、解题或生成网页;如今,测试者开始要求模型制作完整 Mac 应用、开发可玩游戏、根据照片重建三维住宅,并参与数学证明、医学教育、电路设计和商业数据分析。
这是否意味着 AGI 已经到来,目前仍无法下结论。判断模型能力不能只看跑分或精心剪辑的演示,更需要观察它能否在真实环境中连续工作数小时,稳定调用工具、发现并修复错误,最终交付可验证的成果。等 Astra 面向更多用户开放后,长任务实测将比宣传视频更有说服力。

暂无评论,期待您的发言...