DeepSeek发布多模态视觉模型,首批解读
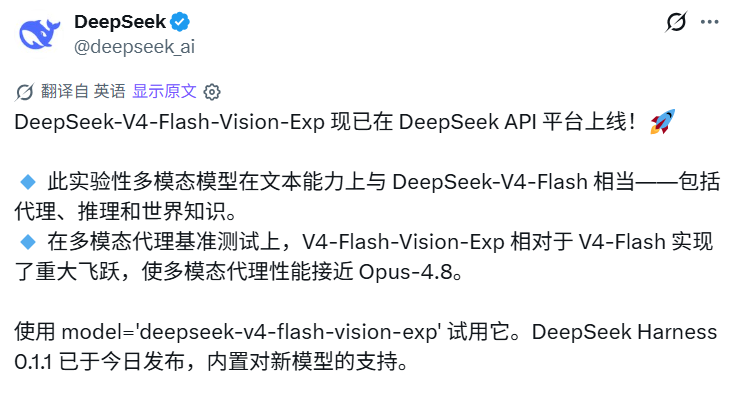
DeepSeek正式发布多模态视觉理解模型DeepSeek-V4-Flash-Vision-Exp,API已开放调用。该模型支持读取图片、截图、图表中的文字与视觉信息,纯文本能力与V4-Flash一致,多模态Agent能力接近Opus-4.8。本文梳理模型细节、图片格式、接口调用方式、Token计费与消息限制,帮助开发者快速上手。
DeepSeek正式发布多模态视觉理解模型 DeepSeek-V4-Flash-Vision-Exp,API已开放调用。该模型能够读取图片中的文字、图表、界面和视觉信息,纯文本能力与DeepSeek-V4-Flash正式版持平,多模态Agent能力接近Opus-4.8。
模型细节
这是一个实验性质的视觉理解模型,调用名为 deepseek-v4-flash-vision-exp。它不用于生成图片,而是让模型读取图片中的文字、界面、图表等信息后结合用户输入回答。
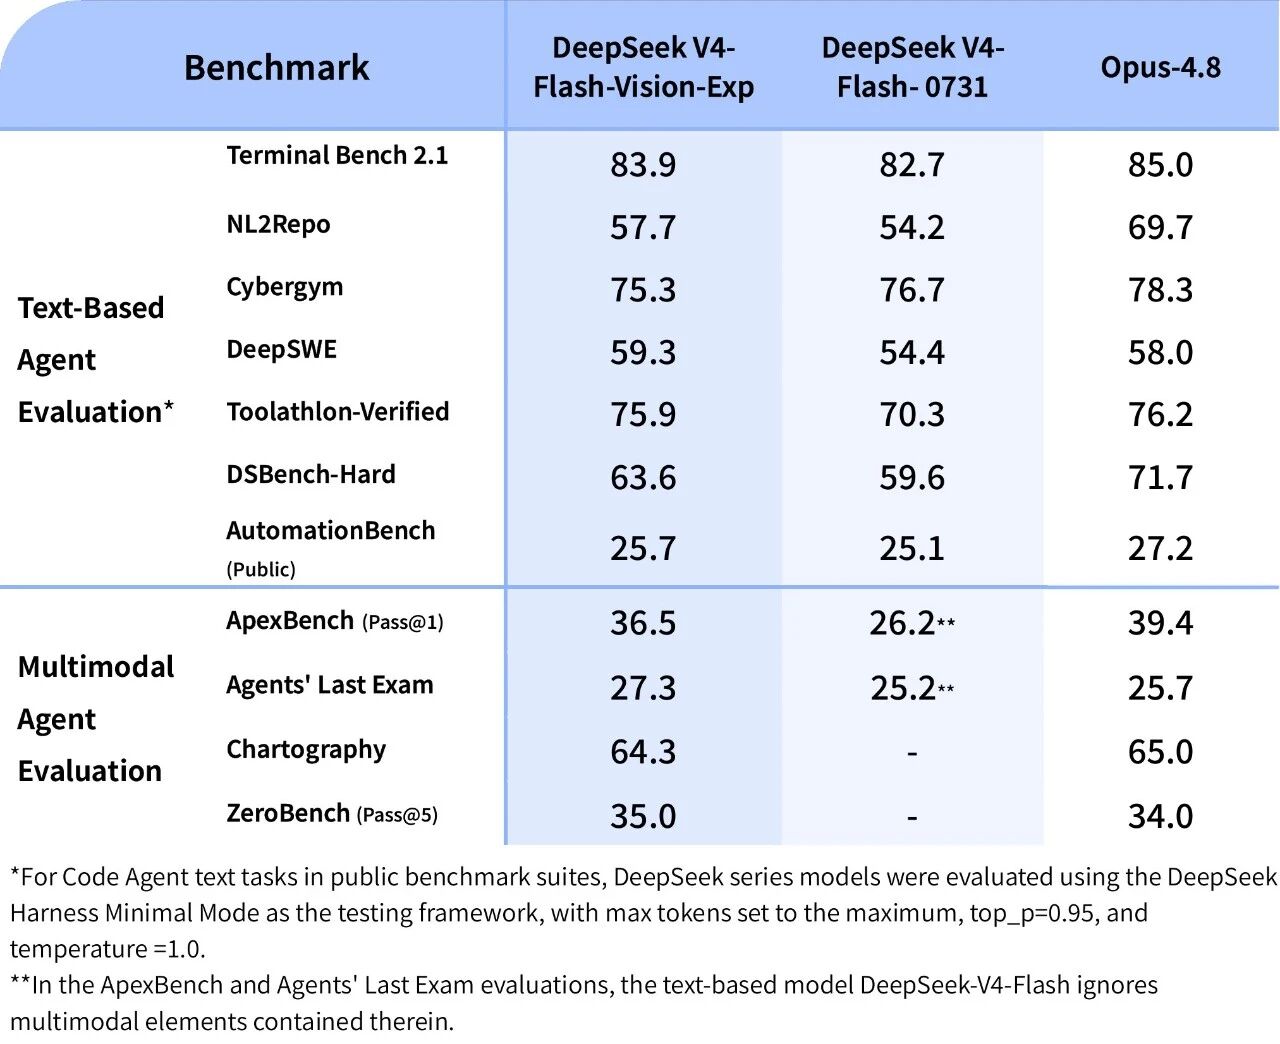
官方给出的基准成绩:Terminal Bench 2.1 为83.9,Chartography为64.3,AutomationBench为25.7。在纯文本能力上,它与DeepSeek-V4-Flash正式版持平;在需要视觉理解的Agent Benchmark上相比正式版有大幅提升,多模态Agent能力已接近Opus-4.8。
支持的图片类型
官方支持以下图片类型:
- JPEG
- PNG
- GIF
- WebP
图片格式由文件实际内容判断,不只看文件名或请求声明的MIME类型。把真实的PNG改名成.jpg并不会变成JPEG,接口仍按文件内容处理。
常见使用场景包括:读取网页或软件截图、从图片表格提取文字和数字、分析数据图表、理解多张图片差异、根据截图解释页面结构。
图片不是直接塞进字符串里
视觉接口采用OpenAI兼容对话格式,消息中的content是内容块数组,而不是普通字符串。最简结构如下:
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {"type": "text", "text": "请描述这张图片,并列出其中的文字"},
        {"type": "image_url", "image_url": {"url": "https://example.com/image.png", "detail": "original"}}
      ]
    }
  ]
}
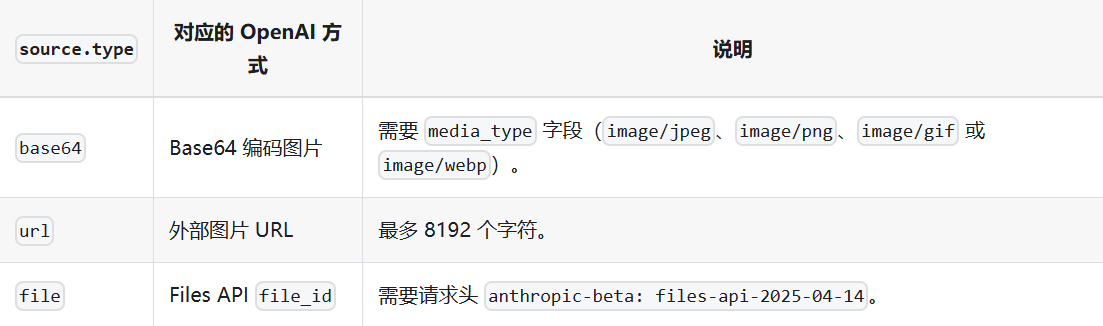
官方提供三种传图方式,供不同场景选择。
方式一:Base64图片
将本地图片编码后,以 data:image/...;base64,... 形式嵌入请求,适合快速处理本地文件,但会受请求体大小限制。
方式二:外部图片URL
传入可公开访问的http或https图片链接,DeepSeek会自动下载。URL最长8192个字符,图片最大32MiB,需在60秒内完成下载。
方式三:Files API
先通过Files API上传图片,再引用返回的file_id。适合重复引用同一张图片或图片过大,通过file_id引用时单张最大可达64MiB。
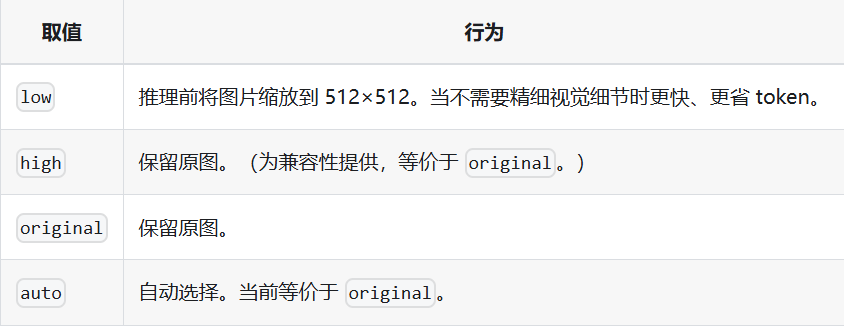
detail参数
detail控制图片进入模型前的处理方式,官方提供包括low、original在内的四种取值。
{"type": "image_url", "image_url": {"url": "https://example.com/image.jpg", "detail": "low"}}
如果只需了解图片大致内容,low可能已经够用;若要读取截图中的小字、表格数字或分析界面布局,使用original更合理。当然,原图清晰度、文字大小和提示词写法也会影响识别效果。
图片也会消耗Token
图片会根据尺寸换算成Token,并与文本Token一起计费。处理逻辑如下:
- 总像素小于约384×384的图片,会保持长宽比放大;
- 更大的图片会保持长宽比缩小,缩小后总像素规模约相当于800×800;
- 每张图片消耗Token存在上限,约为384 Token;
- 一次请求包含多张图片时,每张图片独立计算。
大图不一定会无限增加Token,但被缩小后,小字可能更难识别,所以成本和效果并非图片越大越好。
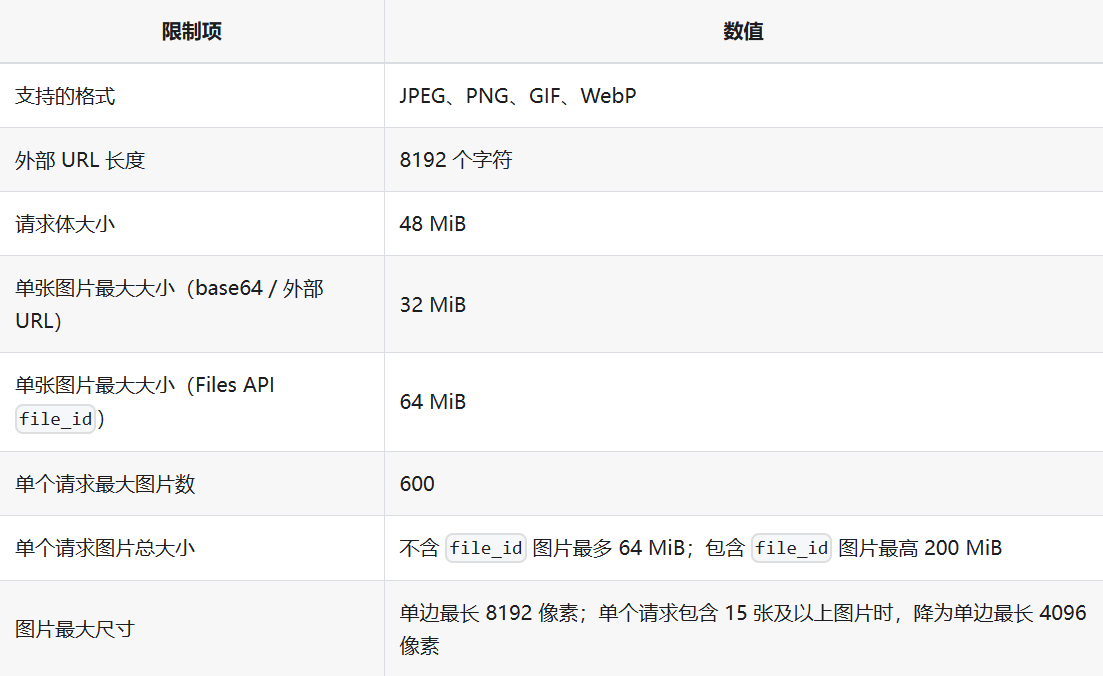
一次最多可以传多少张图片?
官方文档对单次请求的图片数量有限制,实际使用时应根据任务需要决定上传数量,并确认模型能在多张图片中抓住重点。具体数值请以最新API文档为准。
图片只能放在哪些消息里
在Chat Completions中,图片只能放在user消息里。放到system或assistant消息会返回400错误;将图片传给不支持视觉输入的模型也会报错。若使用Responses API,图片内容块变为input_image;若使用Anthropic兼容接口,则用Anthropic格式的image块。
写在最后
DeepSeek终于推开了多模态的大门,不再只处理文字,也开始理解图片、图表和真实世界信息。从能够接收图片到真正看懂图片,再到基于视觉信息可靠完成任务,还有很长的路要走,但这是重要的第一步。希望DeepSeek继续保持探索未至之境的勇气。

暂无评论,期待您的发言...