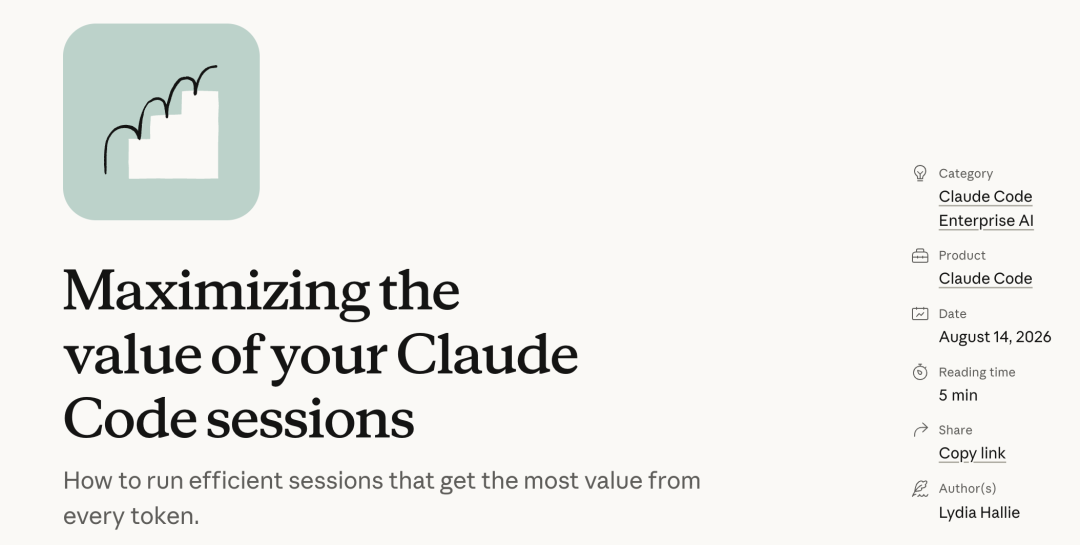
Claude Code 官方教程:把 Session 用到极致,省 token 技巧
Claude Code 官方发布 Session 使用效率提升指南,涵盖 /clear、/model、/effort、@-mention、quiet 参数与 /compact 等实际技巧。文章通过五步请求示例说明 Prompt cache 机制及缓存失效场景,帮助开发者减少 token 浪费,提升 AI 编程效率。
Claude Code 官方近期发布了一篇实操性很强的文章,专门讲解如何提升 Session(会话)使用效率,把每一个 token 都花在刀刃上。核心结论是:不同任务尽量用 /clear 清空对话;开始前确认 /model 和 /effort;引用文件用 @-mention;给命令加 quiet 参数;离开前先 /compact。这些动作都能显著降低 token 消耗,尤其在长会话中效果更明显。
为什么同样的任务,token 消耗差很多
在传统编辑器(如 VSCode、IDEA)里,改一个 bug 和改五十个 bug,费用不会变化。但 Claude Code 这类 Agentic Coding 工具按 token 计费,不同使用方式下,同一个任务的 token 消耗可能相差数倍。
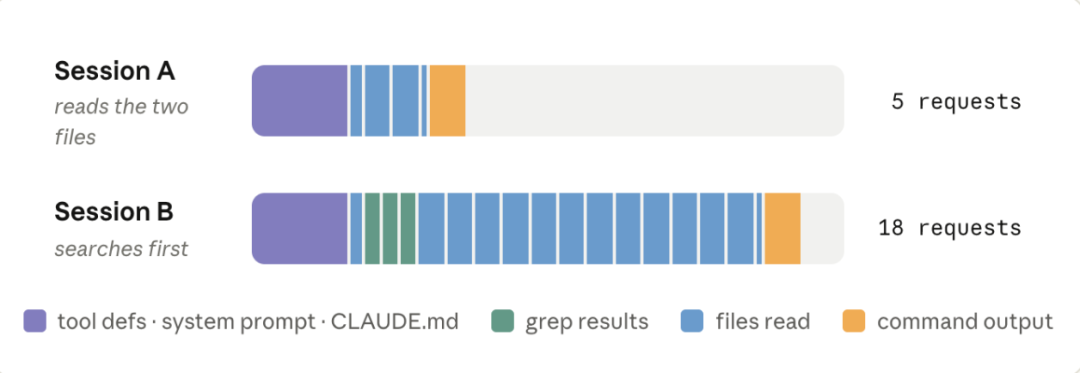
官方用两个 Session 做对比:一个 Session 直接读测试文件和对应源码,改完跑测试,几轮结束;另一个 Session 在仓库里四处搜索,为了找到目标文件读了一堆无关内容,这些内容进入上下文后,每一轮都会跟着请求发送,导致 token 消耗剧增。
所以,提高 token 效率不是一味少用,而是确保每个 token 都产生实际价值。
token 价格由什么决定
Claude 按 token 计费,实际支付的是背后的推理成本(GPU/TPU 处理时间)。一个 token 的价格主要受三个因素影响:模型、输入/输出类型、是否命中缓存。
模型
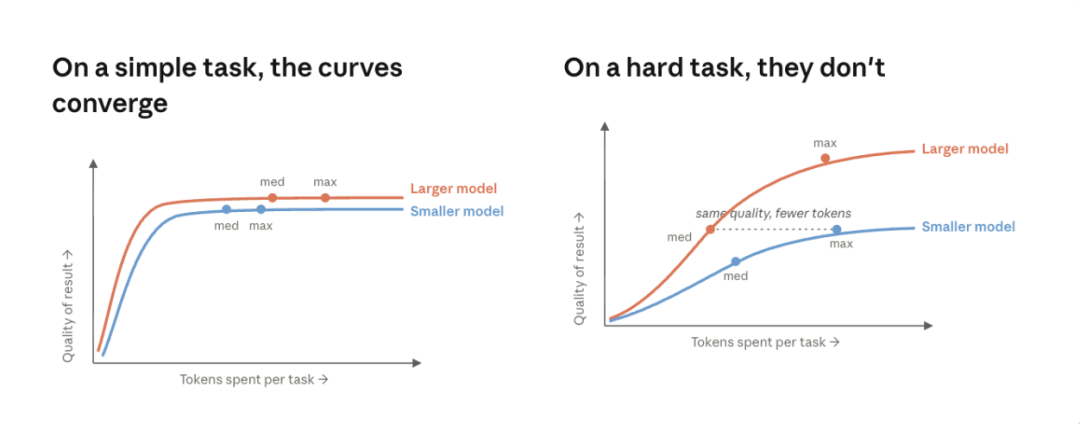
模型参数量越大,计算成本越高。遇到复杂推理任务再上大模型;简单重复工作(改变量名、跑测试)用小模型即可。Claude Code 中可通过 /model 切换。
以下图片分别展示了简单任务和复杂任务下,不同模型与 effort 程度的对比:
输入与输出 token
一次请求分为两个阶段:
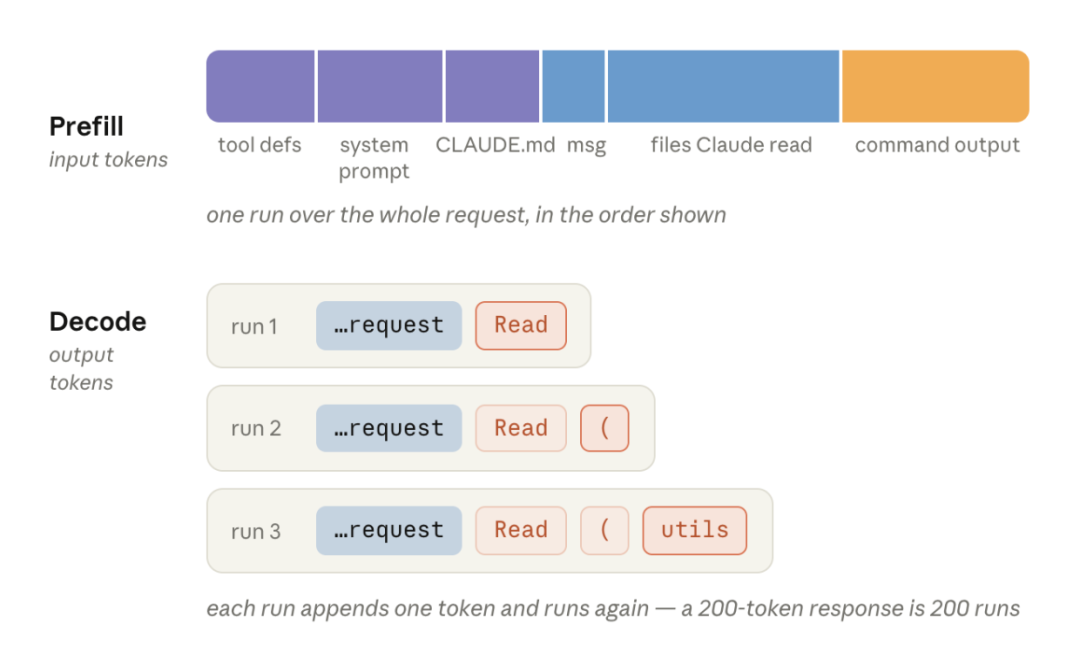
- Prefill(预填充):模型先读取当前上下文,包括 system prompt、CLAUDE.md、历史消息、文件内容、命令输出等。这些属于输入 token。
- Decode(解码):模型逐个生成 token,包括 thinking、工具调用和最终回答。这些属于输出 token,价格约为输入的 5 倍。
下图分别展示了 prefill 和 decode 阶段包含的内容:
/effort 控制每一轮思考投入量。新开 Session 时先用 /model 和 /effort 确认当前设置,避免一上来就拉满。如果这次 Session 全是重复、明确、不需要深入推理的工作,可以用 MAX_THINKING_TOKENS=0 启动 Claude Code,关掉额外 thinking(Fable 5 除外)。
Prompt cache
Prompt cache 机制:如果新请求的开头与刚处理过的请求完全一致,服务器直接加载已保存的 state,只需对新内容做 prefill。缓存读取价格约为普通输入的 0.1 倍;首次写入缓存可能达到普通输入的 2 倍。Claude Code 会自动管理缓存,但某些操作会人为破坏缓存。
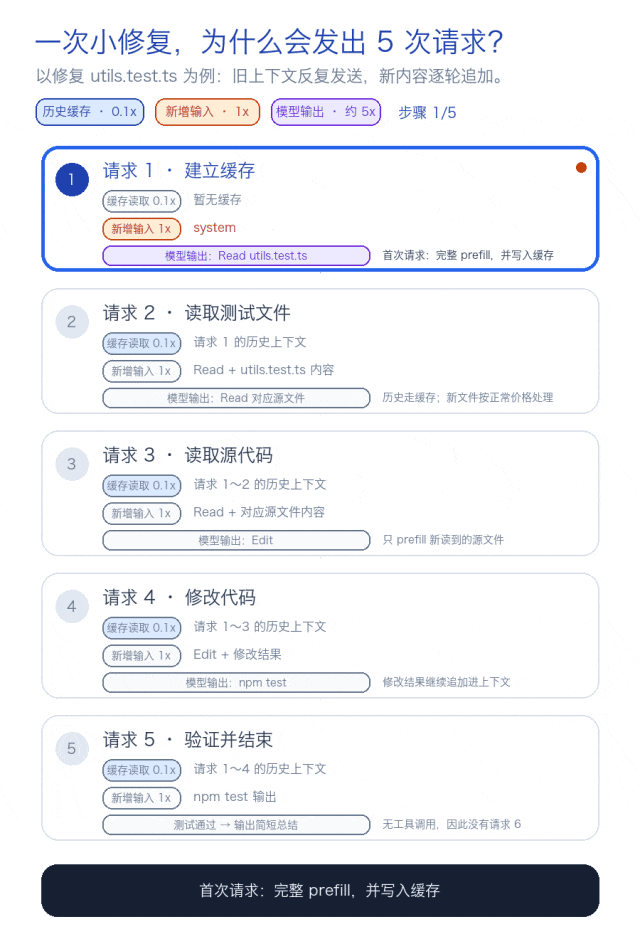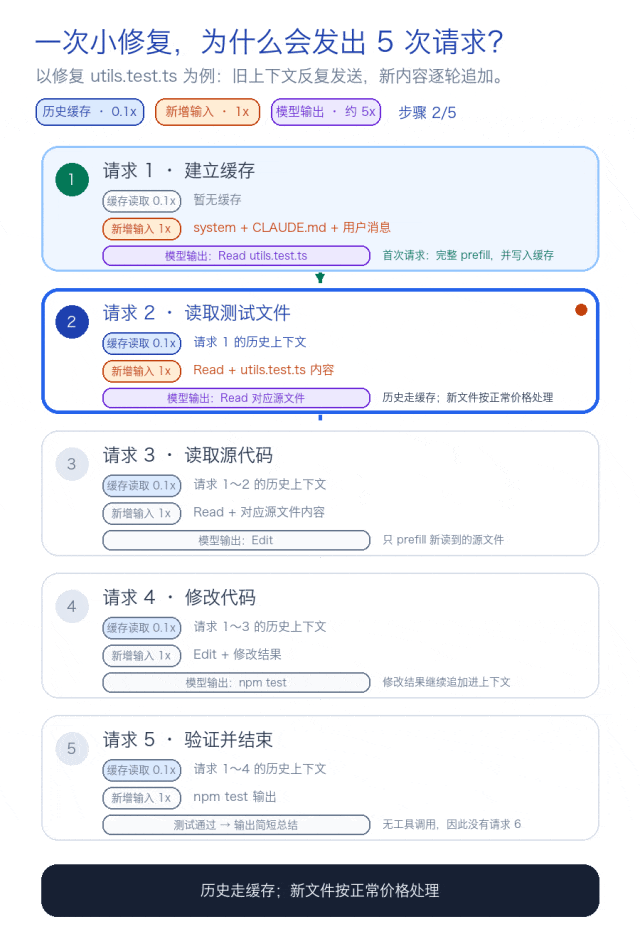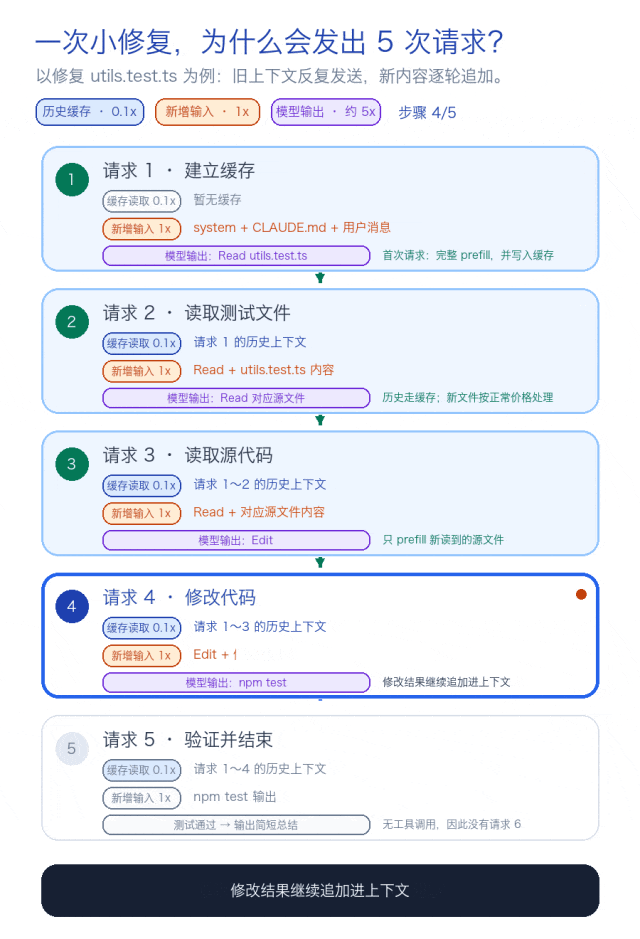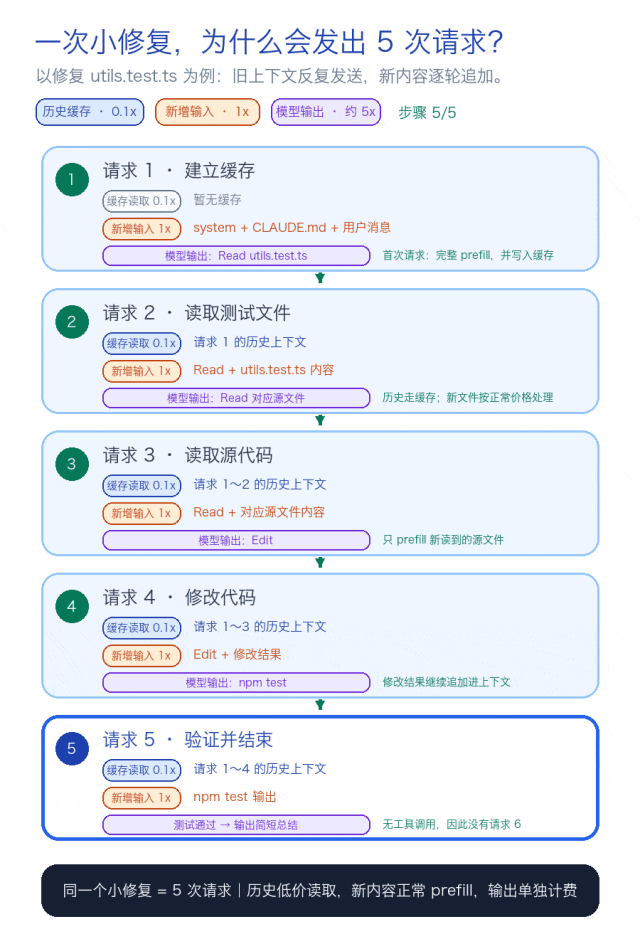
以 Fix the failing test in utils.test.ts 为例,整个过程实际会发出 5 次模型请求:
- 第一次请求:缓存为空,全部 prefill 并写入缓存。
- 第二次请求:模型生成 Read 工具调用,Claude Code 读取文件,追加内容后发起请求,历史内容走缓存,新增文件需正常 prefill。
- 第三次请求:继续读取第二个文件,追加后再次请求。
- 第四次请求:模型生成 Edit 工具调用,修改结果追加后继续请求。
- 第五次请求:运行 npm test,测试输出追加后请求,最后生成总结,任务结束。
每一轮请求的成本大致由三部分组成:历史上下文(缓存价)、本轮新增内容(正常输入价)、模型生成的 thinking/工具调用/回答(输出价)。即使订阅套餐,也按同样逻辑消耗额度。
容易导致缓存失效的操作:
- /model:不同模型各自独立缓存,中途切换会让后续请求重新 prefill。
- /effort:effort 级别是缓存 key 的一部分,中途修改效果等同切换模型。
- Fast mode:是否开启 Fast mode 也参与缓存匹配,中途开启会重新按 Fast mode 价格 prefill。
- /compact:上下文压缩会重写整个对话,只有 system prompt 保留。但若旧对话仍在缓存中,压缩成本不高。
- 时间:订阅模式缓存约一小时后过期;API key 默认五分钟,设置
ENABLE_PROMPT_CACHING_1H=1可延长至一小时。超时后下一轮需要重新 prefill。
如果对话跑偏,可用 /rewind 回退,它只剪掉末尾几轮,前面内容仍能命中缓存;/compact 则会重写全部对话,必然产生新成本。
一个 Session 到底会发送多少 token
Claude 读过的文件、命令输出都会在后续每轮中重复发送。它们大部分能命中缓存,所以重复发送较便宜,但不是免费。更重要的是,这些内容一直占据上下文窗口,影响每一轮思考。
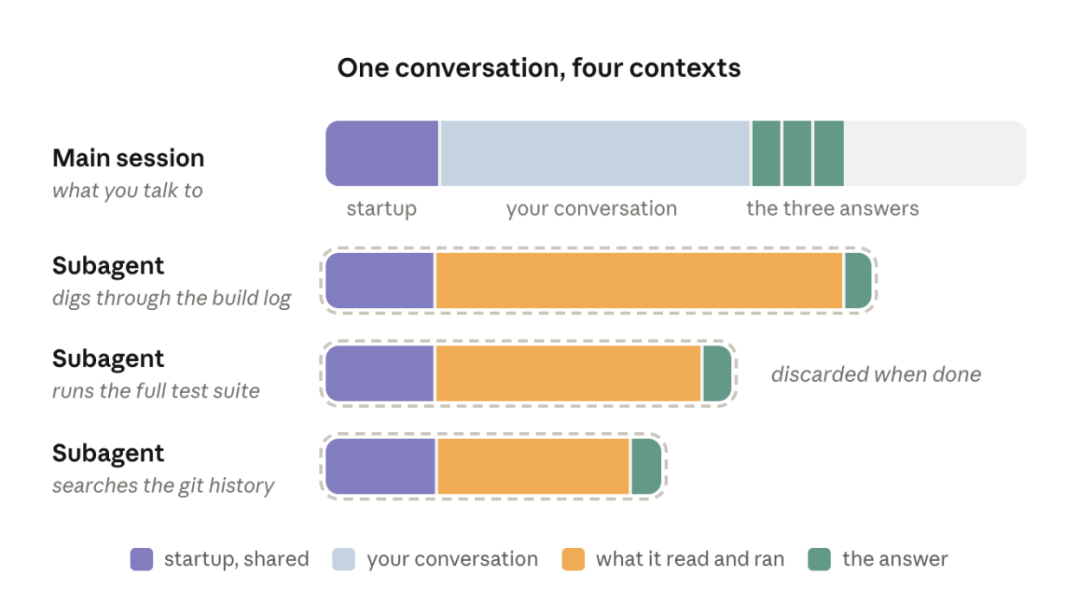
一个 Session 的成本取决于:多少 token 进入上下文、它们存在了多少轮、以及同时开了多少个上下文。
什么内容会进入上下文
在你输入第一句话之前,上下文中已有工具定义、system prompt、CLAUDE.md 等。新开 Session 后运行 /context,可以查看尚未工作时已占用的上下文:
CLAUDE.md 尽量只保留长期有效的规则;临时工作流用 Skill 按需加载;用不到的 MCP server 通过 /mcp 关闭。
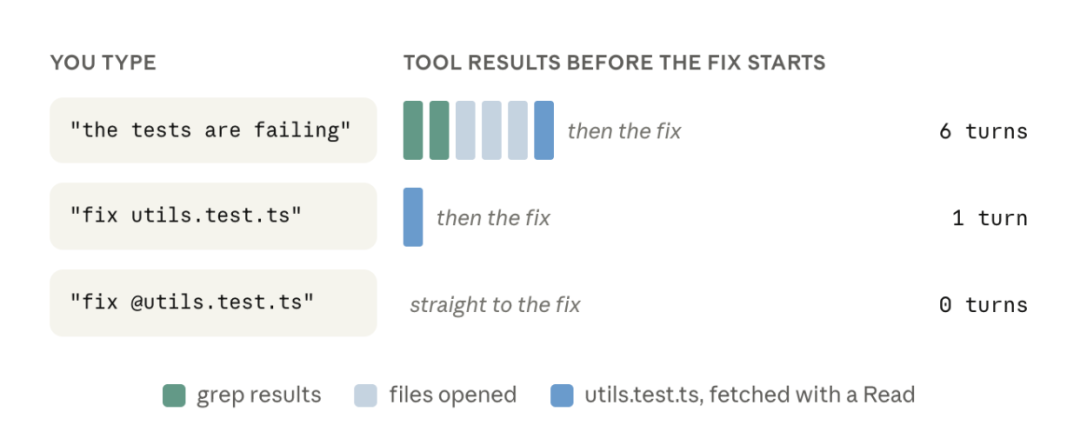
Session 开始后,最容易塞满上下文的通常是工具调用结果,如读取的文件和命令输出。直接说“测试失败了”,Claude 要先搜索;直接写 Fix the failing test in utils.test.ts,会跳过搜索去 Read;写成 Fix the failing test in @utils.test.ts,文件会在第一条消息前直接附加,连 Read 都省了:
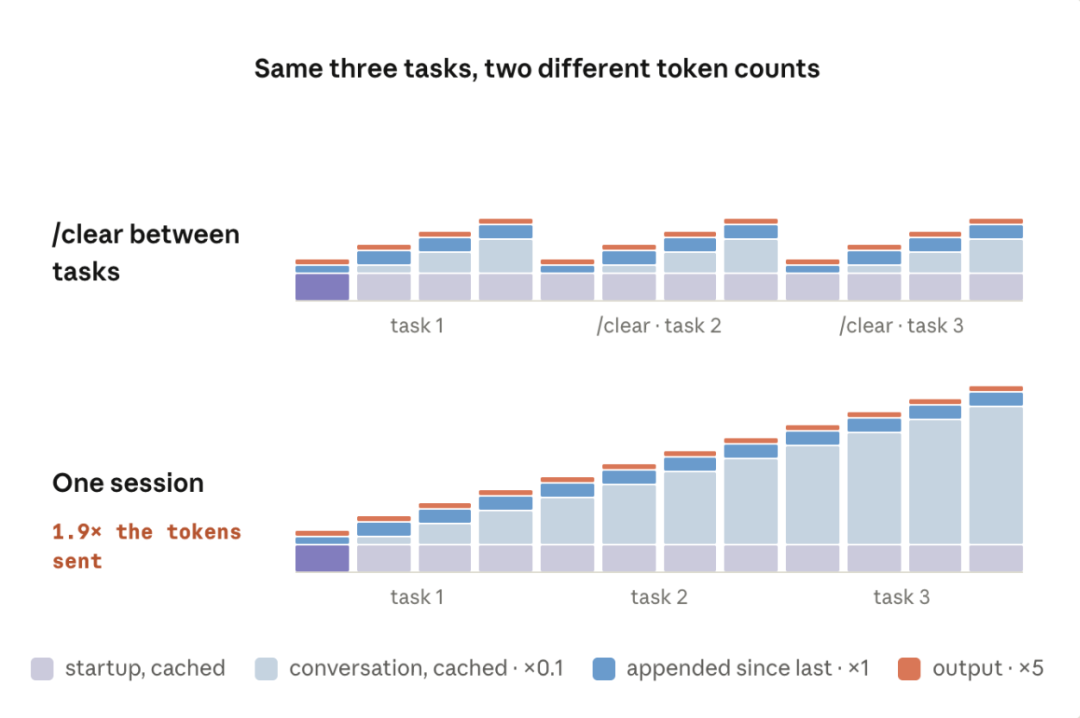
@-mention 与手动 Read 的文件本身占用的上下文空间一样,区别在于省掉了工具调用。同一个文件在对话中提一次就够了,反复 @ 会重复附加文件。
另一个大户是命令输出。每次运行测试、构建、git log,终端内容都会像文件一样进入对话并一直保留。超过 30,000 字符时,Claude Code 会把完整输出写进文件,只保留一小段预览和路径,阈值可通过 BASH_MAX_OUTPUT_LENGTH 修改。
比较麻烦的是那些未超限、但又臭又长的输出——比如测试工具把 400 个通过的测试逐行打印,因为没有超过 30,000 字符限制,这 400 行会全部进入上下文,造成不必要的 token 消耗。
因此,给测试、构建、日志等命令加 quiet 参数,或交给 Subagent 去处理,能有效避免这些输出污染主上下文。
省流版总结
- 不同任务之间使用
/clear,别让旧任务上下文带到新任务。 - 开始前用
/model和/effort确认模型与思考强度,中途切换会破坏缓存。 - 引用文件用
@-mention,省一次 Read 调用。 - 命令加 quiet 参数或交给 Subagent,避免输出占用上下文。
- 新开 Session 后运行
/context,了解初始上下文占用。 - 暂时离开前先
/compact,缓存未过期时压缩成本更低。
把这些习惯用起来,能明显改善 Claude Code 的 token 使用效率。

暂无评论,期待您的发言...